
9月17日,华为全联接大会2026在上海举行。华为副董事长、轮值董事长汪涛发布业界首个采用NPO技术的昇腾960超节点,单节点可扩展至4096颗NPU高速互联,面向十万亿参数大模型训练与推理;与此同时,HarmonyOS 7向Agent亲和架构演进,小艺成为系统级智能中枢;华为宣布未来三年再投50亿元加码鲲鹏昇腾生态。三件事放在同一时间轴上,勾勒出华为从芯片到操作系统再到行业落地的完整AI拼图——当单点算力追赶不再是唯一叙事,以系统能力重构AI基础设施的路径正在浮出水面。
#### 算力底座叙事:昇腾960与互联维度的“换道”
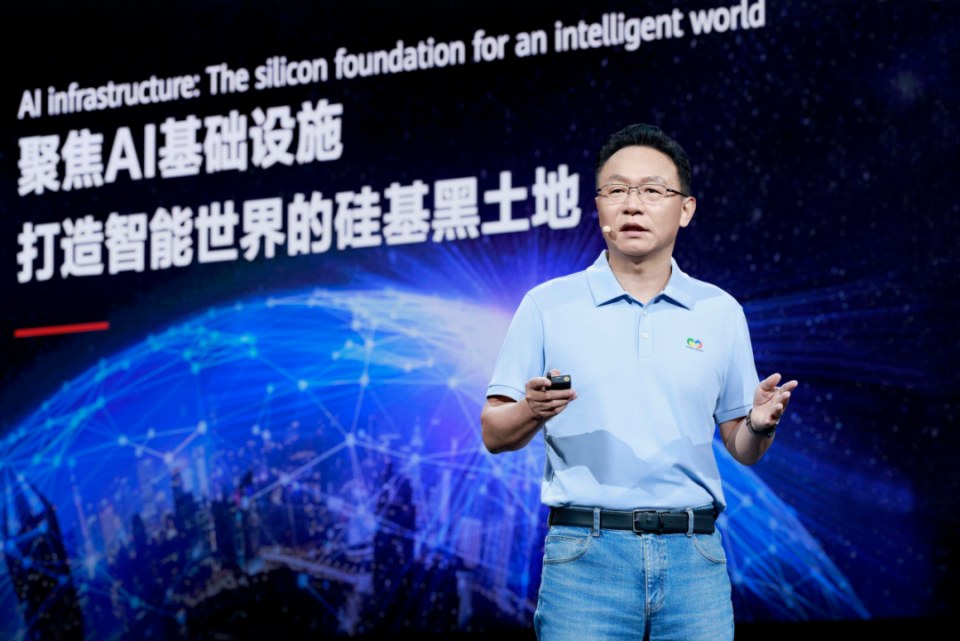
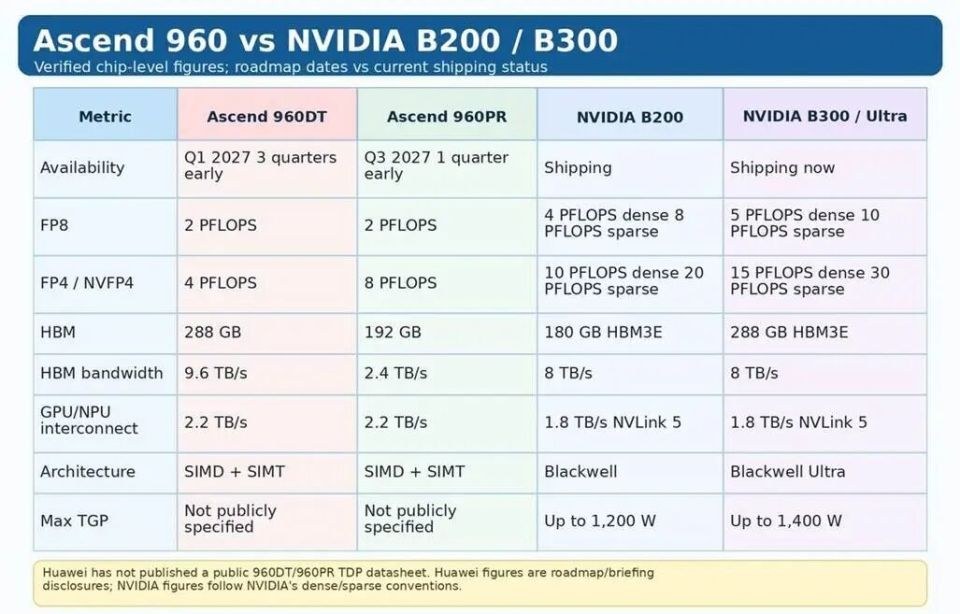
昇腾960的发布,最值得关注的并非单芯片参数,而是其背后的技术路线选择。汪涛在大会上明确:昇腾960芯片研发进度超出预期,960DT比原计划提前三个季度、2027年第一季度就绪,960PR提前一个季度、2027年第三季度就绪,未来昇腾系列芯片保持一年一代演进节奏。这一节奏本身,便是对“先进工艺不可获得”约束的回应——不再在制程这一被锁死的维度上硬碰,而是将资源投向系统与联接的广阔“面”上。
昇腾960超节点正是这套思路的集中体现。单个超节点4096颗NPU高速互联,基于自研灵衢UnifiedBus互联协议与Hi-ONE NPO光引擎构建,实现内存统一编址,RTT时延最低2微秒,提供8E FP8算力与1PB HBM容量。汪涛特别纠正了一个概念误区:“很多人简单把所有服务器卡连在一起就叫超节点,其实这是一个误区。”用RoCE、IB连接起来的本质上仍是集群,而超节点的核心特征在于内存语义、超低时延与超大带宽——逻辑上呈现“一台计算机”的特征。
NPO技术路线是此次发布对光通信产业链最具实质意义的信息。NPO(近封装光学)介于传统可插拔光模块与CPO共封装光学之间:将光学器件独立封装并部署在芯片附近,在缩短电信号路径、降低功耗的同时,保留光引擎可插拔、可独立维护的特性。相比CPO将光学器件与交换芯片封装在同一基板、故障后无法单独更换的局限,NPO在制造良率与运维成本之间取得了工程平衡。华为在光互联标准组织OIF提出NPO标准立项建议,并获得多家行业伙伴响应;此前7月,华为已联合中国移动研究院、百度、京东云等二十余家产业链单位发起OPEN NPO项目,推出国内首个NPO光互连MSA协议。
具体到产品层面,Hi-ONE单引擎传输容量达7.2T,是业界首个量产的NPO产品、行业目前传输能力最大的NPO产品,也是唯一实现内置光源的NPO产品。昇腾960超节点用5500个Hi-ONE替代原本需要的4.8万颗800G光模块,功耗降低超过550千瓦,系统无故障运行时间提升一倍,系统可用度达99.8%。华为围绕超节点及集群已开发11颗关键芯片,覆盖计算、互联与存储领域——这比英伟达Vera Rubin架构的同类芯片数量还多出4颗,折射出华为在系统级协同上的布局密度。
互联之所以成为华为算力战略的轴心,背后有清晰的理论支撑。何庭波提出的“韬(τ)定律”不再将晶体管几何尺寸缩小视为半导体进步的唯一方向,而从信号传播时间、逻辑结构等维度寻找计算性能提升空间;廖恒提出的《嵌套并行冯·诺依曼架构与嵌套式BSP》则指出,冯·诺依曼教会我们构建存储程序计算机,但八十年来将多台计算机连成网络就能形成一台更大计算机的推论是错误的。实现嵌套式BSP原理的硬件,正是灵衢UnifiedBus。这种从芯片、节点到大规模计算系统的整体扩展路径,为国产算力在过渡期提供了框架性指引。
商业落地的数据为这条技术路线提供了注脚:昇腾超节点已部署超过1000套,客户超过370家,是国内唯一训练出SOTA模型的超节点,昇腾950超节点已进入规模商用。从一个概念到装机千套,用了不到两年。
#### 终端操作系统叙事:HarmonyOS 7的Agent化转身
如果说昇腾960解决的是“算力从哪来”,HarmonyOS 7回答的则是“智能如何被触达”。9月7日发布的HarmonyOS 7,在本届大会上进一步明确了AI路径:新一代鸿蒙操作系统正向Agent亲和架构演进,小艺成为操作系统中的智能中枢。
这一架构转变的实质,是应用被调用的方式发生了根本变化。过去用户需要知道功能藏在哪个应用里,发一个指令应用执行一个动作;在HarmonyOS 7上,应用能力以Skill或智能体的方式可供调用,系统理解意图后设计解决方案,再调度最合适的应用完成任务。小艺可结合200多项系统级数据、2100多项系统级能力,联动合作伙伴贡献的500多个精选Skills和2000多个鸿蒙智能体,完成从“听懂一句话”到“执行一件事”的跨越。
鸿蒙智能体框架HMAF 2.0将这套能力开放给第三方:Skill适合确定性强的简单任务,A2A面向多轮交互的复杂场景,支持端侧与云侧两种接入模式。核心调度层在用户授权与沙盒机制下引入语义路由,将复杂需求拆解为可执行的子任务链,复杂任务完成率达90%以上。鸿蒙版腾讯视频率先接入A2A,小艺可直接与应用内“AI小助理”协作,一句话调出片单,追剧时被人物关系绕晕,问题不用退出播放页就能被解答,数据在本地闭环。
从“用户找应用”到“意图即服务”,应用分发逻辑正在被改写。对开发者来说,入口不再只是桌面图标,服务能力能否被系统理解、被小艺调用,将成为Agent时代新的流量命题。而星河互联的升级解决了多设备协同的连接问题:在底层分布式架构优化后,可实现250MB/s多路并发传输,设备间建连时间缩短至数百毫秒,并面向OpenHarmony、iOS及更多第三方系统开放。连接对象从“设备”转向“场景”,服务跟随人的行动流转。
搭载HarmonyOS 6和7的终端设备已突破8500万台,鸿蒙原生应用突破10万。这个规模意味着,Agent化操作系统的竞争已经从概念验证进入生态比拼阶段。
#### 生态与落地叙事:智谱协同、50亿投入与“生态拐点”
算力基础设施与操作系统之外,生态是华为AI战略的第三极。本屆大会的两个信号值得关注。
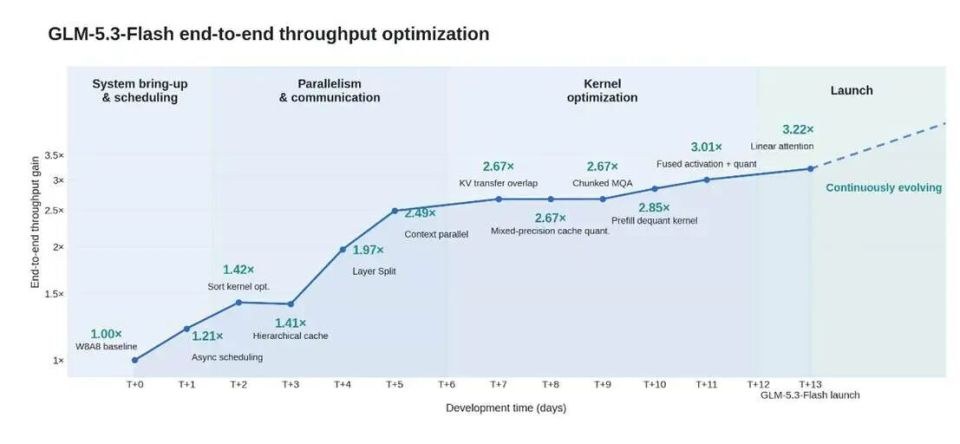
其一是华为与智谱的算力协同。智谱披露,其Infra Agent优化10万卡国产算力集群,帮助GLM-5.3-Flash在6天吞吐62万亿token,不到两周端到端token吞吐量累计提升至3.2倍,并据此判断“硬件效率和单token成本已达到与主流英伟达GPU相当的水平”。他们以“以算力换带宽、以通信换显存”为思路,在SGLang基础上构建专用推理引擎,覆盖算子开发优化、性能瓶颈诊断与服务栈改进。
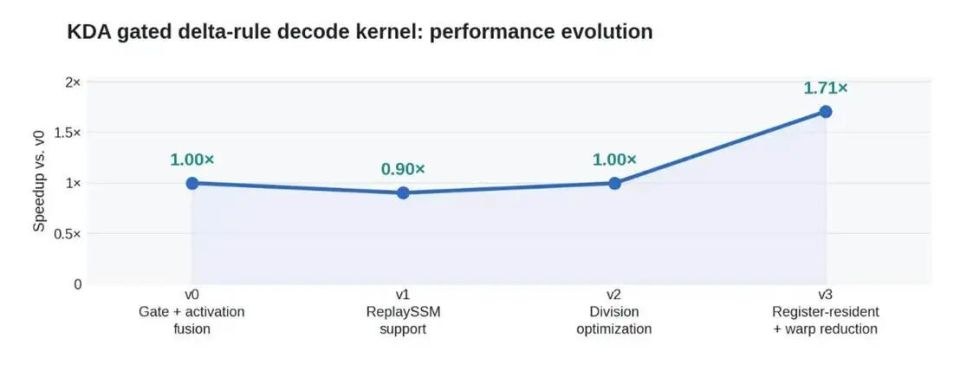
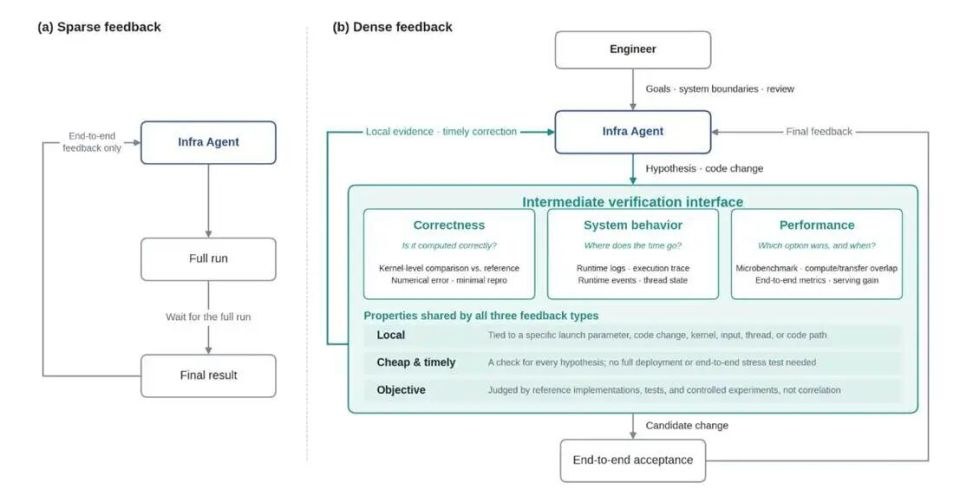
智谱团队引入Infra Agent建立反馈闭环:智能体根据测试、轨迹、基准等“稠密反馈”自主提出假设、修改代码并验证结果。这些反馈信号“本地、易得、客观”,直接关联具体参数或路径,验证周期短、无效投入少。在其优化过程中,KDA解码内核从v0到v3各版本持续迭代,加速比最终升至1.71倍。这一案例的行业意义在于:国产算力集群的差距正在通过系统软件层面的深度优化被迅速抹平,而华为与本土模型厂商之间正在形成“算力—模型”协同进化的正循环。
其二是生态投入的再度加码。华为计算首席战略官朱照生宣布,未来三年(2027-2029年)将再投入50亿元建设开源开放的算力新生态,较2024年宣布的30亿元投入额度显著提升。这印证了算力产业竞争逻辑正从“拼硬件”向“拼生态”深层迁移——芯片决定算力上限,生态决定算力能走多远。华为给出的三段式使能路径覆盖开发者从入门到立业的全周期:能力筑基阶段依托鲲鹏昇腾社区和开发者学习中心;持续创新阶段通过联创、卓越孵化中心与专业赛事让开发者在实战中打磨身手;产研协同阶段通过种子计划和伙伴计划帮助开发者完成从创新到产业转化的“最后一公里”。
生态的厚度正在形成质变。昇腾CANN开源社区月均活跃用户数超过5200人,自6月起成为国内活跃度最高的开源社区;非华为开发者数量已超过华为开发者,日均新增合入代码超3万行;基于昇腾完成预训练的大语言模型和多模态模型超过40个,昇腾成为国内唯一支持预训练的AI算力平台;昇腾还成为第一个可以在PyTorch官网直接选择安装的中国硬件厂商。朱照生据此判断:昇腾已跨过生态拐点,完全有能力在Agentic时代构建AI新生态。
“每个开发者都是生态中最具创新力量的个体”“没有任何一家公司能独自支撑整个智能世界”“每家都磨好自己的豆腐”——这些表述背后是一套清晰的生态哲学:华为聚焦AI算力基础设施,模型公司做好模型,合作伙伴围绕产品和服务形成自身能力,利润的“堰”做低,给上下游留出空间。
#### 产业视角:从“三线叙事”到“一个拼图”
将三条叙事并置观察,华为AI战略的完整性便显现出来:昇腾960超节点提供算力底座,HarmonyOS 7定义智能触达方式,生态投入与产业协同确保落地闭环。三者互为条件——没有超节点的大规模互联能力,Agent化操作系统所需的端云协同推理便缺乏算力支撑;没有OS层面的意图理解与分发机制,算力优势难以转化为用户体验;没有生态的持续投入,软硬件创新便无法形成产业循环。
对国产算力链而言,昇腾960超节点的撬动效应体现在多个层面。首先,NPO技术路线的落地为光通信产业链提供了一份明确的工程清单:7.2Tbps光引擎、36通道、单通道200Gbps、DSP功能集成进交换机ASIC、互连功耗降低约60%。光互联的带宽、时延与可维护性,已成为决定算力集群规模与寿命的关键变量,这为国内光模块、光引擎厂商打开了新的市场空间。其次,灵衢UnifiedBus开放全部技术规范,成为国内首个开放的超节点互联标准,为产业链上下游兼容提供了基准。再者,从“昇腾已跨过生态拐点”的判断来看,国产AI算力正从“可用”走向“好用”:以智谱为代表的模型厂商在10万卡国产集群上实现了与英伟达GPU相当的单token成本,这一事实本身就具备产业风向标意义。
当然,挑战依然存在。单卡性能与英伟达最新产品的差距并未完全抹平,在FP4精度下昇腾960PR的算力约为B300的53%;先进工艺的约束将长期存在,τ定律指引的“逻辑折叠”要等昇腾990那一代才能实现。但华为的应对策略已经明确——不在单一维度上消耗战略竞争力量,而是用系统能力构建整体最优解。正如汪涛所说:“我们是没有退路。但我们认为,没有退路就是胜利之路。”当“山中无路”时,换一条路走,本身就是一种路径创新。
从产业格局看,华为的AI全栈拼图正在改变中国算力产业的竞争维度。当万亿参数大模型成为常态,算力竞争的焦点已从单颗芯片的峰值性能,转向芯片间如何高效通信、系统能否稳定运行、生态能否支撑快速落地的综合能力。在这个层面上,华为构筑的并非某款产品的竞争优势,而是一套可持续演进的技术体系与产业协同网络。这套体系的最终验证,将在未来一年——当昇腾960DT如期就绪、鸿蒙Agent生态进一步壮大、50亿生态投入产生实际回报的时候——正式到来。
 晋ICP备17002471号-6


 分享给我的好友